
はじめに
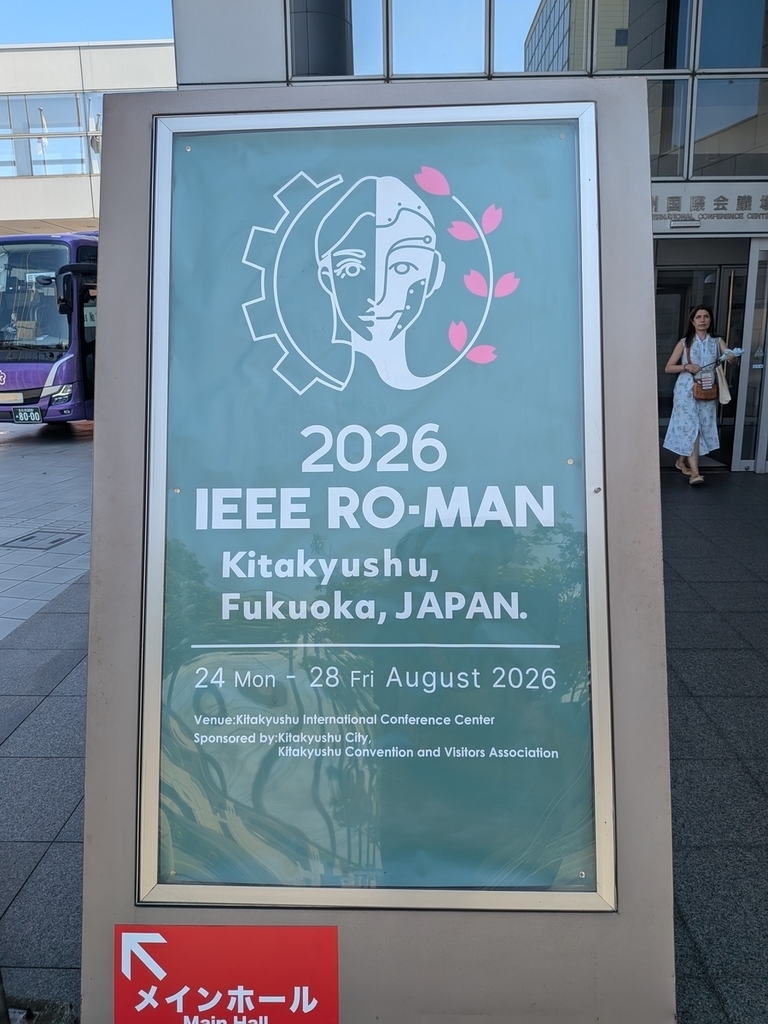
こんにちは、フィジカルAI研究所の山口と森山です。 私たちは2026年8月24日から28日に福岡県北九州市で開催された国際会議「The 35th IEEE International Conference on Robot and Human Interactive Communication (RO-MAN 2026)」に参加し、2件の研究成果を発表しました。本記事では、RO-MAN 2026の会場の様子、発表内容の概要、さらに会場で印象に残った研究を紹介します。
RO-MAN 2026について
RO-MAN(IEEE International Conference on Robot and Human Interactive Communication)は、人とロボットのインタラクティブなコミュニケーションに特化した国際会議です。ロボット工学だけでなく、心理学、認知科学、人工知能、人間工学、倫理など学際的な分野を横断する会議として位置づけられており、2026年で35回目を迎えます。今回は "Realizing Human-Robot Symbiosis with AI"(AIによる人とロボットの共生の実現)をテーマに、ロボットが人間にとって代わるのではなく補完する存在として、人間とロボットが協働するチームの未来を議論する場となりました。
開催情報
- 開催期間:2026年8月24日(月)~ 8月28日(金)
- 開催地:北九州国際コンベンションゾーン(北九州国際会議場)
- 開催形式:ハイブリッド開催
- テーマ:"Realizing Human-Robot Symbiosis with AI"
- 発表件数:389件
- 参加者数:約800名
- 発表形式:口頭発表、ポスター発表(Late Breaking Report Submissionのみ)
- 公式サイト:https://ro-man2026.org/
今回のRO-MANでは、会議の狙いとして「ハイブリッド・インテリジェンス」という概念が掲げられていました。ロボットと人間が共に働くことで、より高い能力・効果・生産性を発揮し、かつ働くこと自体が楽しくなるような未来像を描き、そのために、ロボットが人間と関わる方法や、ロボットの社会的な能力・技能に関する技術革新を促進することが会議の目的とされていました。また、今回は日本開催であったこともあり、日本からの投稿・採択がともに最も多かったとのことでした。
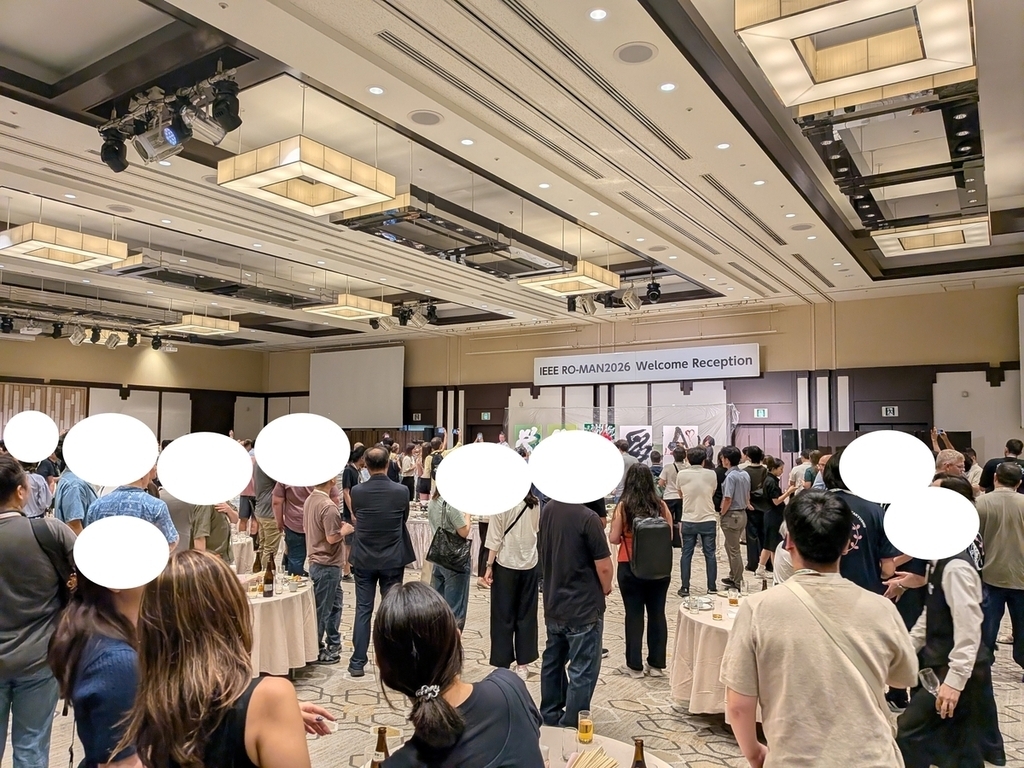
会場の様子
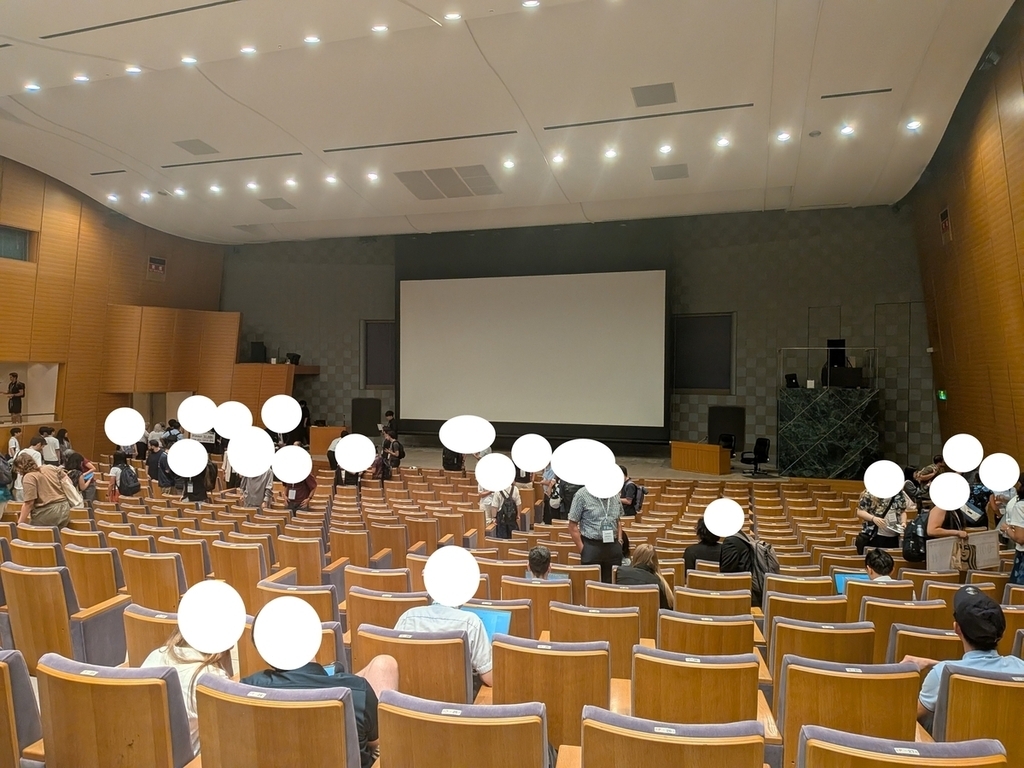
プログラムはワークショップから始まり、基調講演やパネルディスカッション、口頭発表、ロボットデザインコンペティションなど多様なセッションが5日間にわたって開催されました。セッションのトピックは非常に多岐にわたり、ロボットの感情表現や社会性に関する研究から、大規模言語モデル(Large Language Model, LLM)や生成AIを活用したHuman-Robot Interactionに関する最新技術、さらには医療や教育、製造業での応用、倫理的課題まで幅広いテーマが議論されていました。ロボット工学にとどまらず、心理学や認知科学、倫理にまたがるトピックが扱われており、分野の広さが印象的でした。レセプションやバンケット会場では、様々な背景を持つ研究者同士の交流が行われていました。
発表内容
本会議で私たちは2件の研究成果を口頭発表しました。以下では、2件の研究の背景を紹介したうえで、それぞれの技術について解説します。
背景
近年、AIロボットは工場や倉庫などの整備された環境にとどまらず、オフィス、カフェ、店舗、空港など、人々の生活空間に急速に進出してきました。しかし、現在のPhysical AI技術では、人の行動が多様で状況が刻々と変化する空間を十分に理解・予測することが難しく、人とロボットが同じ空間で自然に共存する環境への導入は、いまだ十分に実現していません。この課題を解決するには、個々のロボットがそれぞれ判断するだけでなく、空間全体の状況を捉え、人やロボットの行動を統合的に予測・制御する仕組みが必要です。
そこで富士通では、個々のロボットが目の前のタスクに集中する一方、その背後で空間全体を把握し、空間内の人々の意図や特性を推定して未来を予測することで、各ロボットに適切な指示を与え、望ましい未来へ導く、いわば「空間の脳」の実現を目指しました。この「空間の脳」を実現する技術が、空間World Modelです。
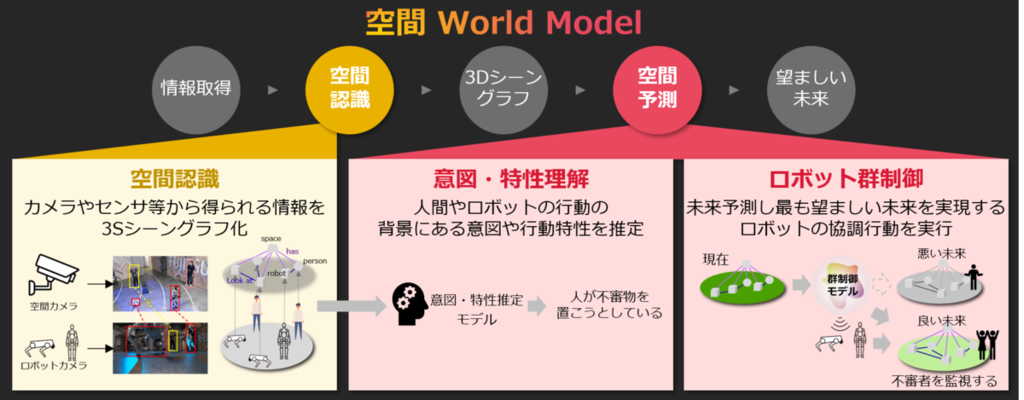
空間World Model
空間World Modelは、「空間認識」と「空間予測」の二つの技術で構成されます。「空間認識」では、絶えず変化する空間の状態をリアルタイムに捉え、3Dシーングラフなど、コンピューターが処理しやすい情報にまとめます。この技術には、富士通が長年にわたり培ってきた物体検知や人物トラッキングなどのComputer Visionの知見を活用しています。一方、「空間予測」では、空間認識で得られた情報を基に、人の行動や空間の変化を予測します。多様な人の行動を直接予測することは難しいため、まず「意図・特性理解」によって、行動の背後にある意図や特性を推定します。続いて「ロボット群制御」により、その推定結果を手掛かりに空間全体の未来を予測し、望ましい状態を実現するためのロボットの協調行動を計算・実行します。空間World Modelは、これらの技術を組み合わせ、空間全体を望ましい未来へと導くことを目指しています。
発表論文の位置づけ
空間World Modelの実現において重要になるのが、空間内に存在する人の行動や、モノの配置、制御可能なロボットの構成が絶えず変化する状況で、人の意図に沿って複数のロボットを協調制御する技術です。この実現には、ロボットの協調相手である人の意図や作業特性を理解する技術と、人やモノ、ロボットの構成が変わっても複数のロボットを安定して連携させる技術の両方が必要です。そこで今回は、「意図・特性理解」の技術として、人間とロボットが混在する複雑な環境で人間の作業特性を推定し、両者の最適な協調を実現する研究①に取り組みました。また、「ロボット群制御」の技術として、空間内のモノ・人・ロボットの構成が変化しても、1つのモデルで複数のロボットを高精度に協調制御する研究②に取り組みました。
本会議では、これらを独立した技術としてそれぞれ評価し、論文として発表しましたが、将来的には両者を組み合わせ、人の意図や特性に応じて複数のロボットを協調制御する仕組みの実現を目指します。
研究①: ToM-Based Agent Trait Estimation for Improving Multi-Agent Cooperation in a Macro-Action Environment
研究背景
人の意図や特性を推定する代表的なアプローチには、LLMを用いる方法と「心の理論(Theory of Mind:ToM)」を用いる方法が知られています。LLMは学習済みの知識を生かして幅広い場面に対応できる一方、複雑なルールを持つタスクでは、推定結果が安定しにくく、計算に時間がかかります。本研究が対象とするのは、次節で説明する複雑な協調タスクです。そこで、タスク環境や協調相手に特化して学習することで、高速かつ安定した推定が期待できるToMに基づく手法を開発しました。
タスク設定
本研究では、2人のプレイヤーが料理を完成させる協力ゲーム「Overcooked」[1]を用います。プレイヤーのうち1人は自律的にタスクを実行する人間役のエージェントで、もう一方が制御対象のロボットです。ロボットを人間の行動に合わせて制御し、配達数を増やすことを狙います。
人とロボットには、各タスクの得意・不得意の程度を表す特性ベクトルが与えられます。各要素は「食材を切る、食材を組み合わせる、加熱する、盛り付ける、提供する」の得意・不得意に対応し、値が大きいほど得意であることを意味します。ただし、ロボットは人間の特性を知らないため、人間の行動履歴から特性ベクトルを推定し、それに合わせて行動を決定することが重要になります。
研究課題
先行研究のToMCAT[2]は、相手の行動履歴から、相手の次の行動と作業特性ベクトルを推定し、その結果を協調行動の計画に活用する手法です。しかし、推定できるのは特性ベクトルの符号、すなわち各作業が得意(正)か不得意(負)か、どちらでもない(ゼロ)かという方向のみで、その程度までは捉えられません。より適切な役割分担には特性の大きさが重要であるため、本研究では、得意・不得意の程度まで推定することを課題としました。
提案技術
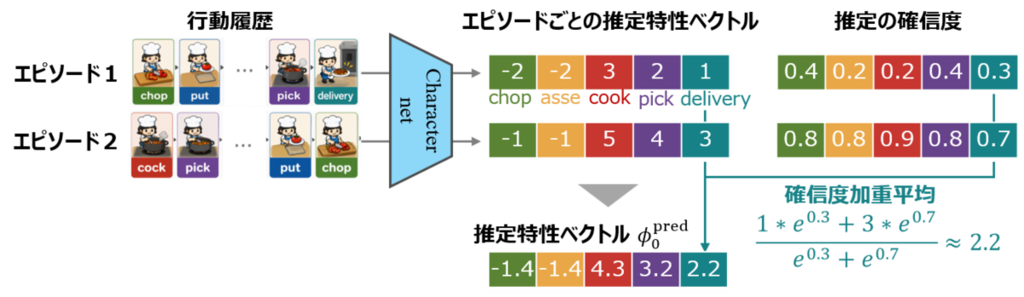
提案技術の全体像を下図に示します。図の右側に示すように、人は自身の特性ベクトルに従って自律的に行動しており、ロボットはその行動原理を知ることができません。図の左側に示す「Trait-Magnitude-Estimation Theory of Mind(TME-ToM)」は、特性推定のコアとなる技術です。TME-ToMは、蓄積した行動履歴から、人の次の行動と、得意・不得意の程度を含む特性ベクトルを推定します。図の中央の「協調モデル」は、この推定結果とロボット自身の特性を比較し、協調相手の人と比べてロボットが相対的に得意な作業を優先できるように行動を決定します。
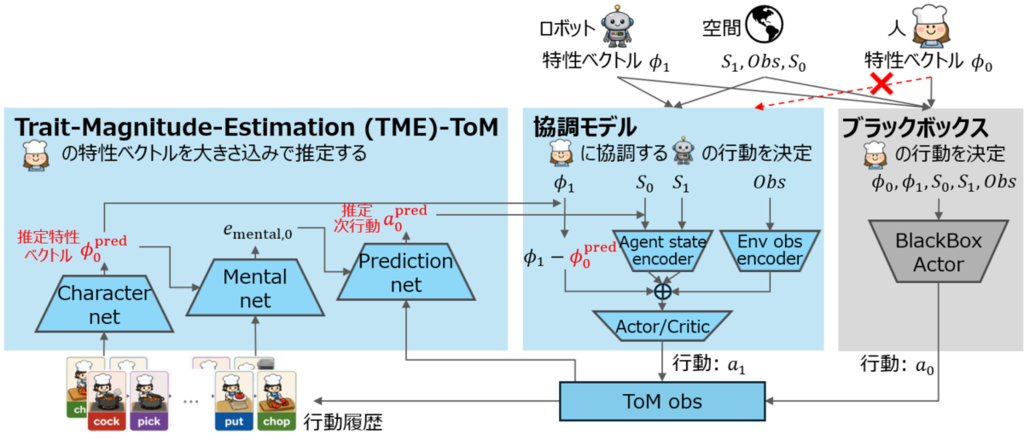
TME-ToMでは、まず行動履歴を時系列モデルであるLSTMで処理し、エピソード(1回のゲームプレイの行動履歴)ごとに各特性の大きさと推定の確信度を算出します。次に、確信度の高いエピソードの推定結果を重視して加重平均することで、特性ベクトルの大きさを高精度に推定します。確信度を用いる理由は、エピソードによって各特性の推定に役立つ情報量が異なるためです。例えば、料理が完成せず提供行動が一度もなかったエピソードからは、「提供する」特性の大きさを推定することが困難です。このようなエピソードの確信度を低くし、加重平均への影響を抑えることで、推定精度を高めます。
実験結果
TME-ToMを用いる場合と用いない場合の制御結果を比較しました。その結果、Overcookedの配達スコアは165から184へと約11.5%向上しました。また、人とロボットが得意なタスクを担当できているかを表す個人スコアの合計も155から226に約45.8%向上し、より良い役割分担を実現できることを示しました。
協調事例
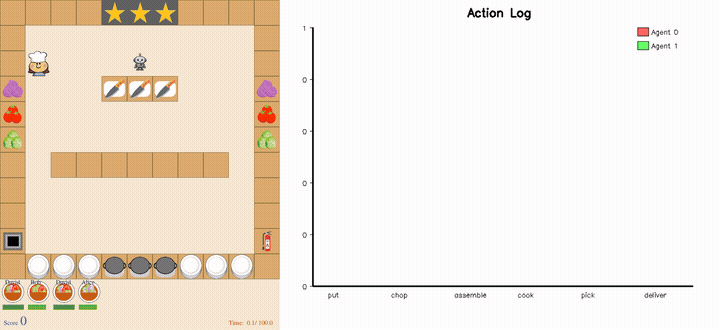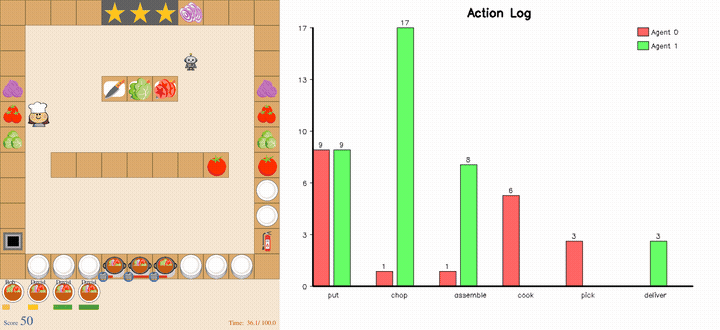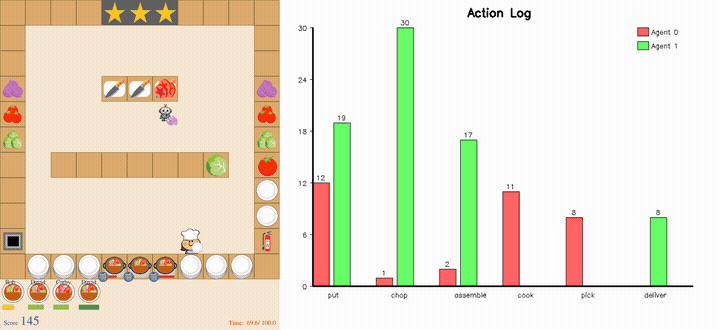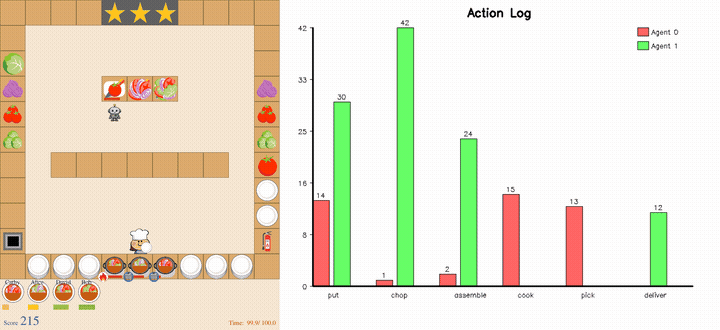
TME-ToMによる特性推定と協調モデルにより、加熱や盛り付けが得意な人と、食材を切る作業や提供が得意なロボットが、それぞれの得意な作業を生かして役割分担する様子を確認できました。
研究② Spatial Graph-based Multi-Agent Reinforcement Learning for Asynchronous Coordination with Dynamic Entities
研究背景
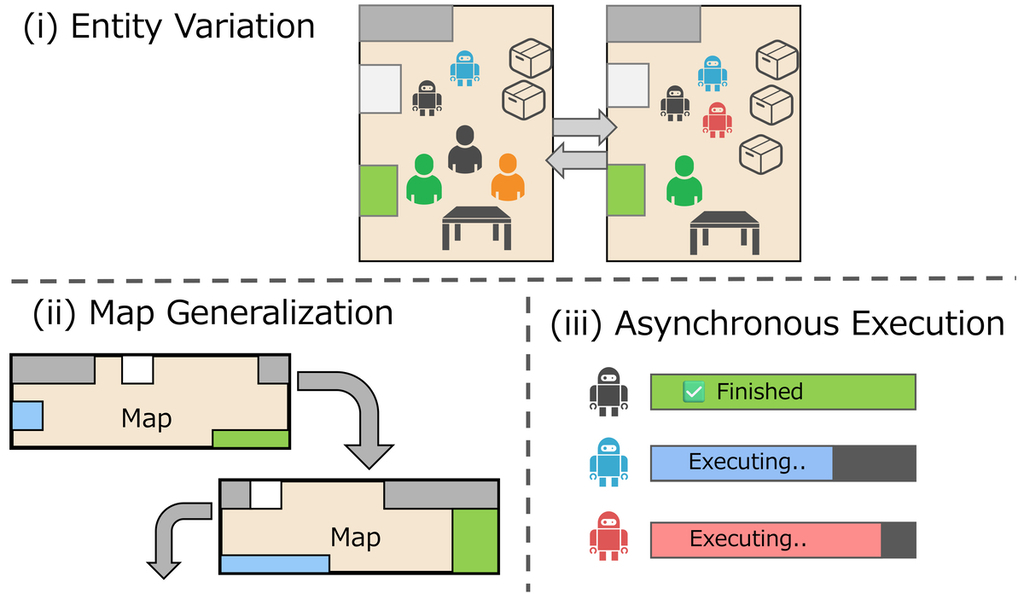
複数のロボットを協調させるアプローチとして、マルチエージェント強化学習(Multi-Agent Reinforcement Learning; MARL)が研究されています。しかし、実世界では周囲の人や物体の数は時々刻々と変化し、環境のレイアウトも場所ごとに異なり、各ロボットの行動にかかる時間も一様ではありません。既存の手法では、これらの変動に同時に対応できる統一的なフレームワークは十分に確立されていませんでした。
提案手法
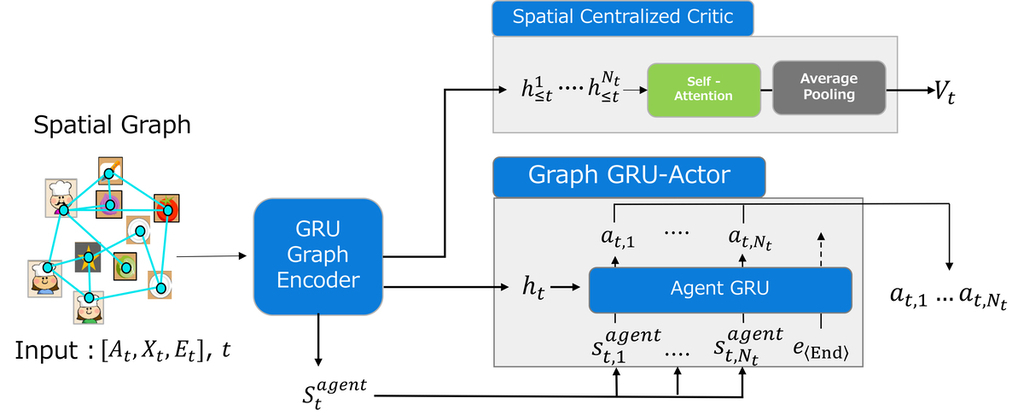
そこで本研究では、Graph Dynamic MARL(GDM)を提案しました。GDMでは、環境中の人やロボット、物体をノード、それらの間の関係(移動コストや進行中の行動など)をエッジとする空間グラフで環境を表現します。グラフ構造を用いることで、ノード数の増減に自然に対応でき、人や物体の数が変動する環境に適応できます。また、マップの座標情報を直接使わず、移動コストなどのマップに依存しない情報をエッジの特徴量とすることで、未知のマップレイアウトへの汎化を可能にしています。さらに、各ロボットが行動を完了したタイミングで次の意思決定を行うことで、行動にかかる時間が異なる非同期な環境にも対応しています。
評価結果
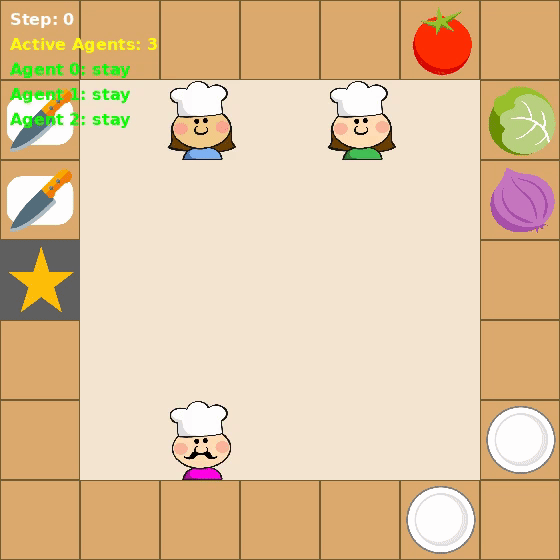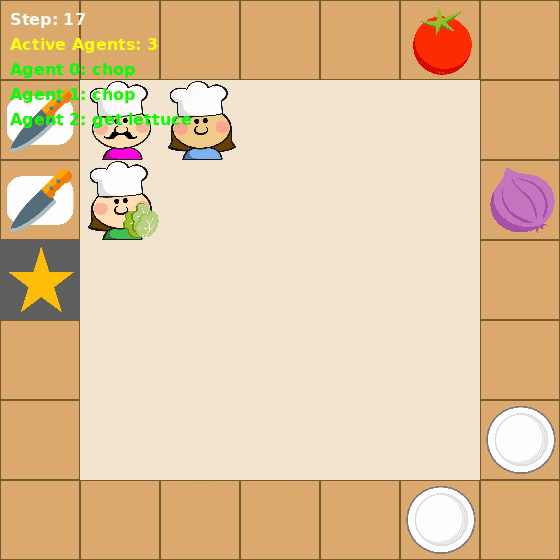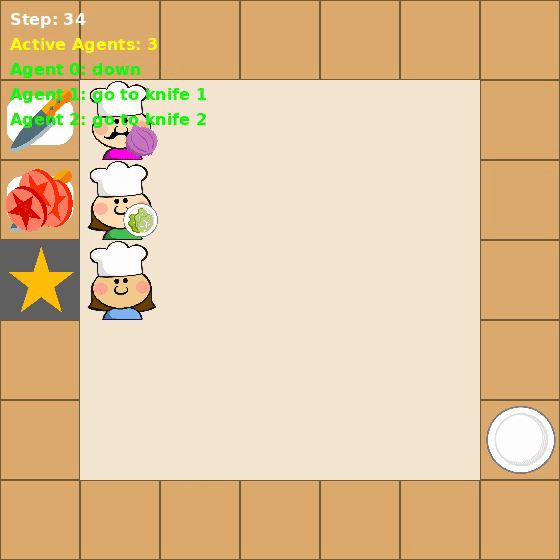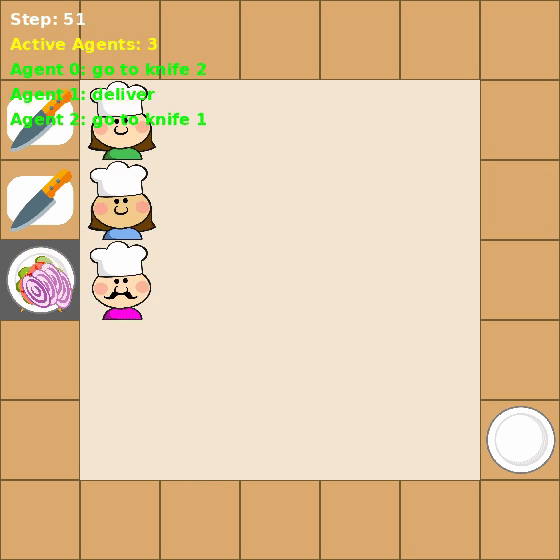
評価には、研究①と同じく料理協力ゲーム「Overcooked」を題材とした、マルチロボット協調のベンチマーク環境[3]を用いました。ただし、研究①で用いたものとは環境と問題設定が異なります。本研究の環境には人エージェントは登場せず、キッチン内で食材を切る、盛り付ける、提供するといったタスクを協力してこなすよう、複数のロボットすべてを制御します。
エージェント(ロボット)数の変動: エージェント数を1〜3台で変化させながら1つのモデルを学習しました。学習したモデルは、エージェント数が時間とともに変化しても料理の配達を達成でき、台数に応じた再学習が不要であることを確認しました。
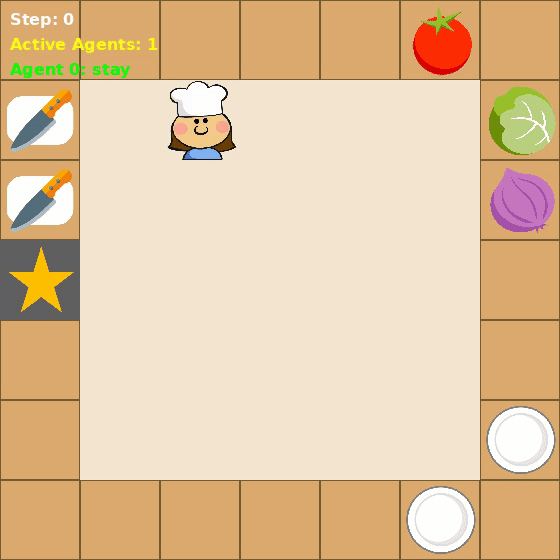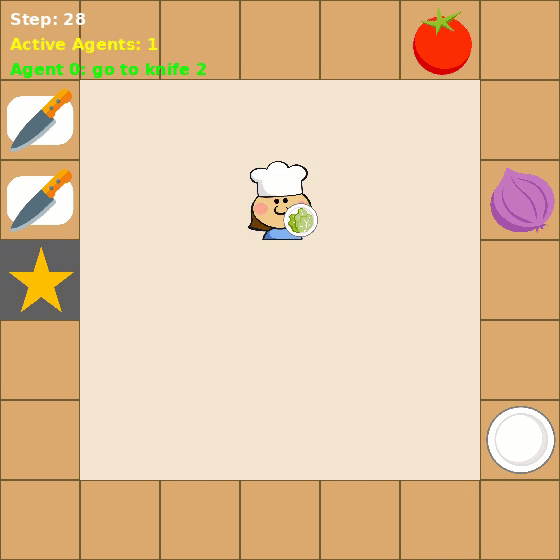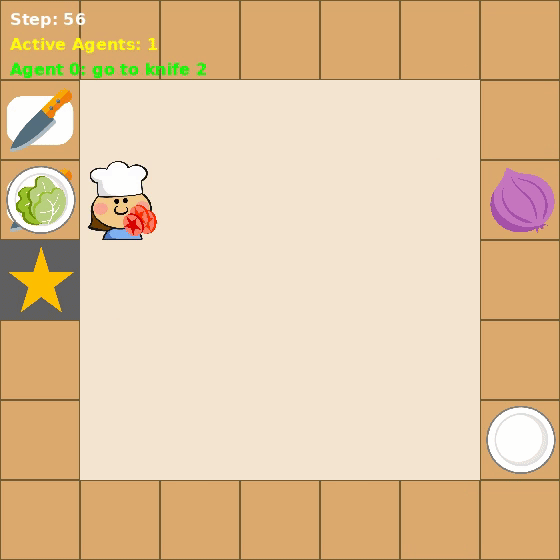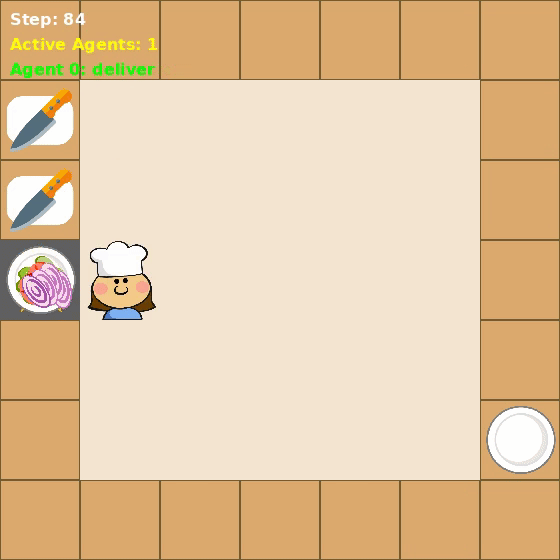
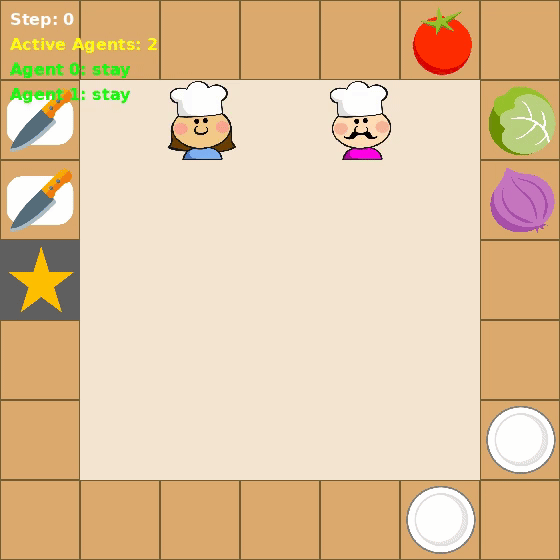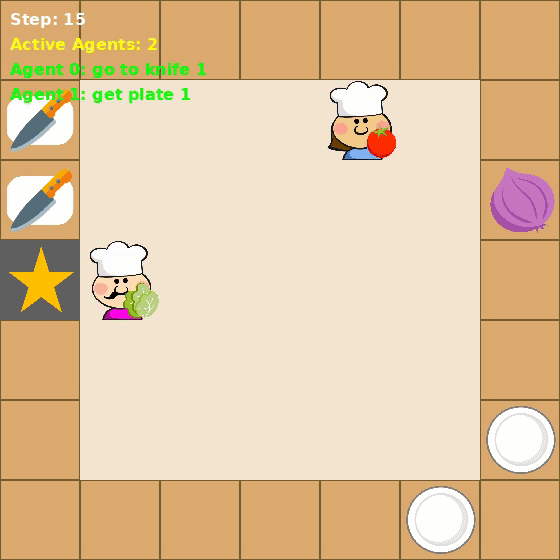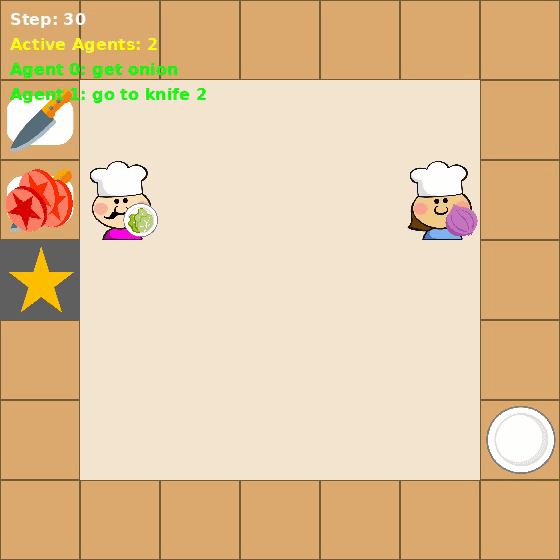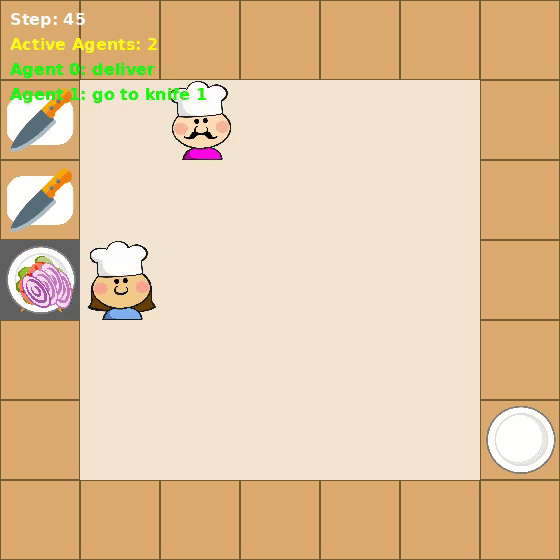
マップ汎化: 訓練時に使用したキッチンのレイアウトに加え、3種類の未知のレイアウトで評価を行いました。既存手法は未知のレイアウトでスコアが大幅に低下したのに対し、GDMはいずれのレイアウトでもスコアを維持しました。
| 手法 | 訓練時のレイアウト | 未知① | 未知② | 未知③ |
|---|---|---|---|---|
| 既存手法[4] | 222.05 | 224.87 | 26.02 | 21.97 |
| GDM(提案手法) | 227.03 | 225.39 | 215.41 | 223.80 |
各レイアウトにおける平均スコア(200以上でタスク成功)
非同期な行動決定: 上記すべての実験はエージェントごとに行動の完了タイミングが異なる非同期な環境で行われているため、非同期な行動決定も達成しています。
以上のように、提案手法がエンティティ(人・モノ・ロボット)数の変動、マップの汎化、非同期な行動という3つの課題に同時に対応できることを示しました。
印象に残った研究
A Multidimensional Study in an Automotive Assembly Scenario with Exoskeletons and Cobots[5]
本論文はBest Paper Awardを受賞しています。 ジェノヴァ大学らの研究グループが発表した、自動車のルーフ組み立て作業を対象に協同ロボット(コボット)とパッシブ外骨格を組み合わせた環境で、作業者の体験を多角的に評価した研究です。実験では、実際の車体を用いた組み立てラインを再現し、自動車組み立て作業に従事する作業者10名を対象に、認知的負荷(NASA-TLX[6])、技術受容(有用性や満足度)、ユーザビリティ(SUS)の3つの定量指標に加え、作業後のインタビューによる定性的なフィードバックを収集しています。興味深かったのは、外骨格が身体的な負担を軽減する一方で、狭い車内での動きの制約により別の種類の負荷を増加させ、「便利だが満足ではない」という機能面と感情面のギャップが示されていた点です。一方、コボットは近接・触覚センサーによる安全性もあり、作業者から一貫してポジティブな評価を受けていました。
単純な性能評価ではなく、認知的負荷やユーザビリティといった使い手目線の評価は、人とロボットの共存にとって重要な観点であると感じました。特に、1つの指標だけでは見えないトレードオフを明らかにしている点は、私たちの研究においても参考になる視点でした。
Incremental Residual Reinforcement Learning Toward Real-World Learning for Social Navigation[7]
九州大学の研究グループが発表した、移動ロボットの実環境学習に関する研究です。 本論文はKROS Interdisciplinary Research Award n Social Human-Robot Interactionを受賞しています。
人を避けながら目的地へ進むソーシャルナビゲーションでは、人の動きが場所や状況によって異なるため、シミュレーションで学習したロボットが実環境に対応できない場合があります。一方、一般的な深層強化学習は過去の経験を大量に保存してまとめて学習するため、計算資源が限られるロボット上での追加学習には向きません。そこで著者らは、限られた実環境データと計算資源で現場に適応するIncremental Residual Reinforcement Learning(IRRL)を提案しました。IRRLは、既存のベース方策に対する補正だけを学ぶ「残差強化学習」と、最新の経験で補正モデルを少しずつ更新する「逐次学習」を組み合わせた手法です。 ベース方策には、目的地への移動と人の回避を行うSocial Force Model(SFM)を用い、その出力に加える補正モデルをシミュレーションで事前学習します。実環境では、ロボットが動きながら得た限られた経験データを使って補正モデルを逐次追加学習し、シミュレーションでは再現できなかった現場の人の動きに適応させます。シミュレーション実験では、SFM単体の成功率が約81%だったのに対し、SFMに補正を加えたIRRLは98%以上を達成しています。これとは条件が異なる実環境実験では、実機ロボットだけを現実の床で走らせ、歩行者をコンピューター上で再現する環境で、補正モデルを100エピソード追加学習しています。その結果、成功率は40%から60%へ向上し、衝突率は60%から40%へ低下したことから、IRRLによってロボットが実機上で現場の人の動きに適応できる可能性が示されています。
既存の方策を生かしながら、現場で必要な部分だけを軽量に学習する考え方は、シミュレーションと実環境の差を埋める実用的なアプローチだと感じました。人とロボットが共存する変化の大きい空間を対象とする私たちの研究にとっても、場所ごとに異なる人の動きへロボットを継続的に適応させるうえで重要な知見です。
おわりに
私たちはロボティクス研究を昨年度から始めたため、ロボット分野の学会への参加は今回が初めてでした。RO-MANでは、技術的な発表だけでなく、人とロボットの関わり方について哲学や倫理の観点から議論するセッションもあり、分野の広がりを実感しました。今回発表した2件の研究は、実世界における人とロボット、あるいは異なるロボット同士のロバストな協調を実現するための重要な技術です。会議を通じて、マルチロボット協調だけでなく、人間中心の評価や安全なインタラクションの設計など、周辺領域の研究にも多くの刺激を受けました。来年のRO-MAN 2027はCanada, Waterlooで開催予定です。引き続き研究成果を発信していけるよう取り組んでまいります。
関連記事
空間World Modelに関連する技術や取り組みについては、他の記事でも紹介しています[8][9]。ぜひ併せてご覧ください。
参考文献
- J. Liu et al., "LLM-powered hierarchical language agent for real-time human-AI coordination," in Proceedings of the International Conference on Autonomous Agents and Multiagent Systems (AAMAS), 2024.
- P. Sequeira et al., "ToMCAT: Theory-of-Mind for Cooperative Agents in Teams via Multiagent Diffusion Policies," arXiv preprint arXiv:2502.18438, 2025.
- Y. Xiao, T. Wei, and C. Amato, "Asynchronous Actor-Critic for Multi-Agent Reinforcement Learning," NeurIPS, 2022.
- W. Jung et al., "Agent-Centric Actor-Critic for Asynchronous Multi-Agent Reinforcement Learning," ICML, 2025.
- S. Borelli et al., "A Multidimensional Study in an Automotive Assembly Scenario with Exoskeletons and Cobots," RO-MAN, 2026.
- S. G. Hart and L. E. Staveland, "Development of NASA-TLX (Task Load Index)," Advances in Psychology, vol. 52, 1988.
- H. Nagahisa et al., "Incremental Residual Reinforcement Learning Toward Real-World Learning for Social Navigation," in Proceedings of the IEEE International Conference on Robot and Human Interactive Communication (RO-MAN), 2026.
- Fujitsu TECH BLOG「"想像"する空間:複数ロボットの協調動作を実現」
- Fujitsu TECH BLOG「FG2026に2件採択! ”人物行動意図推定”と ”人体モーションキャプチャ向けマルチカメラ自己校正”に関する最新技術を紹介」
